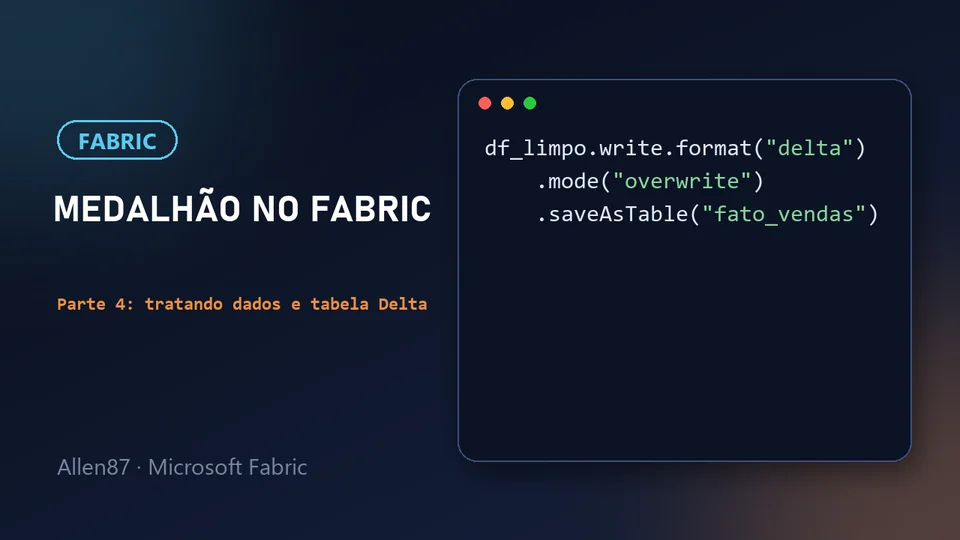
Esta é a parte 4 da série sobre arquitetura medalhão no Microsoft Fabric. Na parte 3 lemos o CSV na silver, ainda bruto. Agora vamos tratar os dados e gravá-los como uma tabela Delta.
Em uma frase: limpamos os dados com PySpark e os guardamos como tabela Delta, que é um formato confiável.

Tratando os dados
Em uma segunda célula do notebook nb_transformacao_silver, trato os problemas do CSV e salvo o resultado como tabela Delta:
# Célula 2: Tratamento de dados e escrita da Delta Table
from pyspark.sql.functions import col

df_limpo = (
    # Remove transações repetidas, usando o id_transacao como chave
    df_raw.dropDuplicates(["id_transacao"])
    # Descarta registros sem valor. É uma decisão de negócio: em outros cenários
    # você pode preencher o valor, marcar o registro ou enviá-lo para uma tabela de rejeitados
    .filter(col("valor").isNotNull())
    # Garante o tipo numérico. Para valores monetários, em projetos reais
    # prefira decimal a double, para evitar erros de arredondamento
    .withColumn("valor", col("valor").cast("double"))
)

# Gravação como Delta Table Gerenciada
(
    df_limpo.write.format("delta")
    # overwrite: sobrescreve a tabela a cada execução (o Delta registra uma nova versão no log)
    .mode("overwrite")
    # saveAsTable: grava e registra a tabela pelo nome no lakehouse (aparece em Tables)
    .saveAsTable("fato_vendas")
)

print("Tabela Delta 'fato_vendas' criada com sucesso no lh_silver!")
O que cada passo faz
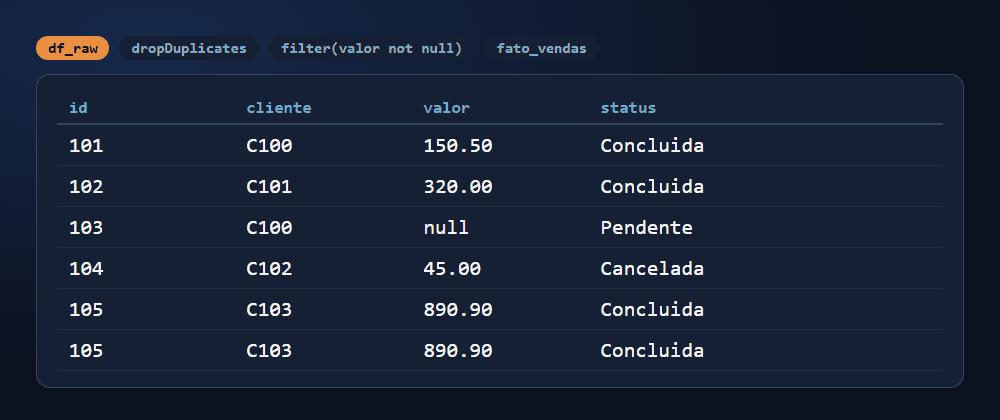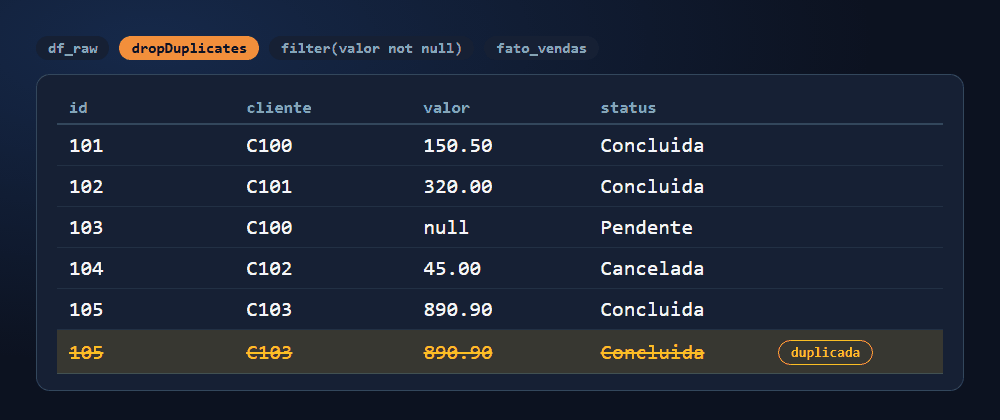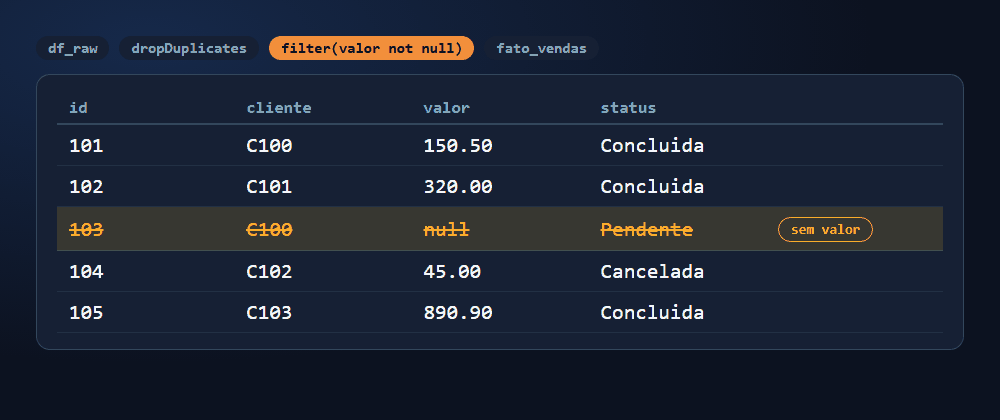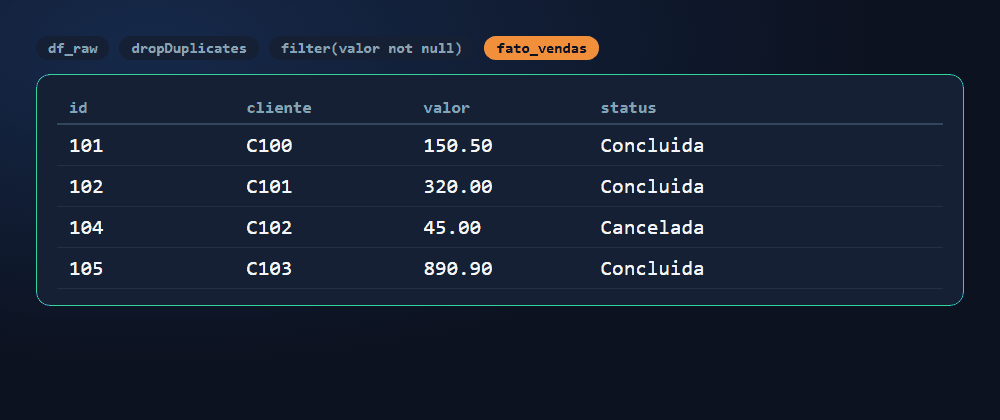
dropDuplicates(["id_transacao"]): remove os registros repetidos, usando o ID da transação como chave. É o caso da transação 105.filter(col("valor").isNotNull()): mantém apenas os registros com valor preenchido. A transação 103, sem valor, fica de fora.cast("double"): converte a colunavalorpara o tipo numéricodouble, garantindo que ela seja tratada como número.
Antes e depois: de seis registros, sobram quatro (101, 102, 104 e 105). Os comentários no código lembram que descartar registros sem valor é uma decisão de negócio e que, para dinheiro, decimal costuma ser melhor que double.
Gravando a tabela Delta
format("delta"): grava no formato Delta.mode("overwrite"): sobrescreve o conteúdo da tabela a cada execução. Isso permite rodar o notebook várias vezes sem duplicar dados. O Delta registra a sobrescrita como uma nova versão no log.saveAsTable("fato_vendas"): grava os dados e registra a tabela pelo nome no lakehouse. Com isso ela aparece em Tables e pode ser consultada por nome, inclusive com SQL. Se eu usasse apenassave()com um caminho, os arquivos seriam gravados, mas a tabela não seria registrada pelo nome no catálogo.
A animação mostra o que acontece por baixo quando a escrita é feita: a primeira vez cria um arquivo Parquet e uma entrada no Delta log; rodar de novo com overwrite cria uma nova versão.
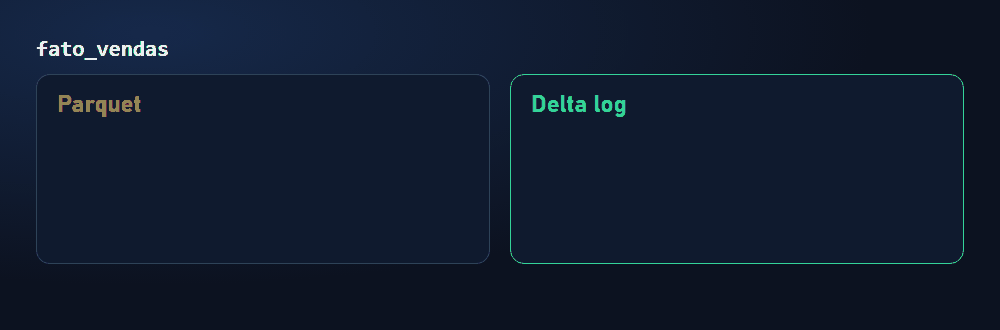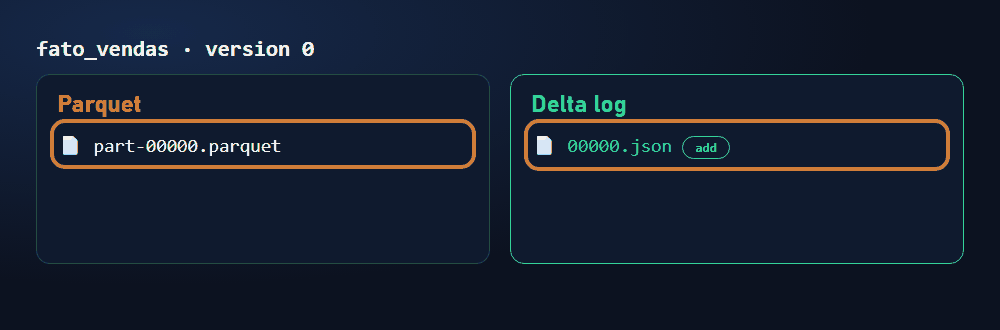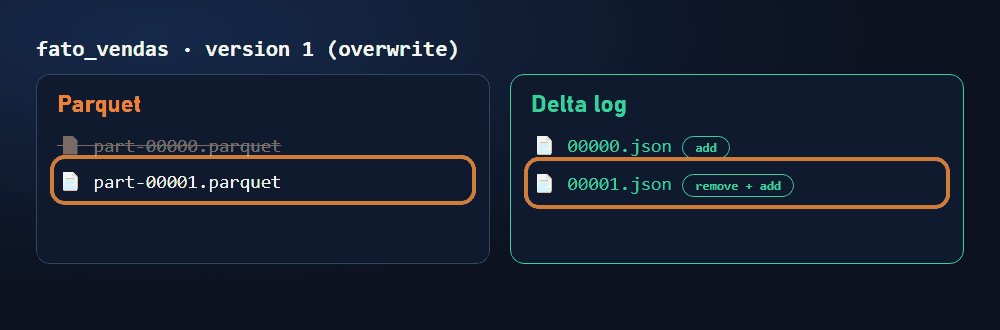
Como o lh_silver é o lakehouse padrão do notebook, a tabela é criada em Tables, como tabela gerenciada: o Fabric cuida tanto dos arquivos quanto dos metadados.
Resultado
Na silver, em Tables, aparece a tabela fato_vendas. O ícone com um triângulo indica que ela está no formato Delta.

Isso fecha a explicação do atalho da parte 3: eu poderia ter transformado o CSV em Delta já na criação do atalho, mas preferi mantê-lo em CSV, tratar os dados no notebook e só então gravar em Delta.
Por baixo do capô: o que é uma tabela Delta
Tudo o que fica em Tables é uma tabela Delta. Por baixo, ela é formada por duas partes:
- Arquivos Parquet: guardam os dados em formato colunar e comprimido, o que permite armazenar e consultar grandes volumes de forma otimizada.
- Delta log (a pasta
_delta_log): o registro de cada transação de escrita feita na tabela.

Parquet e Delta não são a mesma coisa. Os dados são salvos em Parquet, mas o que faz deles uma tabela Delta é o log de transações que acompanha os arquivos. Por isso falamos em "tabelas Delta" ou "dados no formato Delta", e não apenas em Parquet.
Transações ACID
É o Delta log que permite as transações ACID nas tabelas do lakehouse:
- Atomicidade: a operação acontece por inteiro ou não acontece. Se algo falhar no meio, nada é gravado pela metade.
- Consistência: os dados saem de um estado válido para outro estado válido, respeitando as regras definidas.
- Isolamento: transações simultâneas não interferem umas nas outras.
- Durabilidade: depois de confirmada, a gravação é permanente, mesmo que haja queda de energia ou de internet.

Perguntas frequentes
Qual a diferença entre save e saveAsTable?
O saveAsTable grava os dados e registra a tabela pelo nome no lakehouse, então ela aparece em Tables e pode ser consultada por nome, inclusive com SQL. O save com um caminho grava os arquivos, mas não registra a tabela pelo nome no catálogo.
O que acontece se eu rodar o notebook de novo?
Com mode("overwrite"), a tabela é substituída pelo resultado novo e os dados não se duplicam. O Delta registra a sobrescrita como uma nova versão no log.
Parquet e Delta são a mesma coisa?
Não. Parquet é o formato de arquivo que guarda os dados, de forma colunar e comprimida. Delta é o Parquet mais o Delta log, o registro das transações que sustenta o ACID.
Dá para voltar à versão anterior da tabela?
Em geral sim. Como cada escrita vira uma versão no Delta log, é possível consultar versões anteriores (time travel), enquanto os arquivos antigos não tiverem sido removidos por uma limpeza (VACUUM). Esse assunto merece um capítulo próprio.
Para ir além (documentação da Microsoft)
Resumo
- Tratamos os dados com PySpark: removemos o duplicado, descartamos o registro sem valor e garantimos o tipo numérico.
- Gravamos o resultado como a tabela Delta
fato_vendas, em Tables, comsaveAsTable. - Uma tabela Delta é feita de arquivos Parquet mais o Delta log, e é o log que garante as transações ACID.
Na parte 5, vamos consultar a fato_vendas com o SQL analytics endpoint.