Esta es la parte 4 de la serie sobre arquitectura medallón en Microsoft Fabric. En la parte 3 leímos el CSV en silver, todavía en bruto. Ahora vamos a tratar los datos y guardarlos como una tabla Delta.
En una frase: limpiamos los datos con PySpark y los guardamos como tabla Delta, un formato confiable.

Tratando los datos
En una segunda celda del notebook nb_transformacao_silver, trato los problemas del CSV y guardo el resultado como tabla Delta:
# Celda 2: Limpieza de datos y escritura de la tabla Delta
from pyspark.sql.functions import col

df_limpo = (
    # Elimina transacciones repetidas, usando id_transacao como clave
    df_raw.dropDuplicates(["id_transacao"])
    # Descarta registros sin valor. Es una decisión de negocio: en otros escenarios
    # puedes completar el valor, marcar el registro o enviarlo a una tabla de rechazados
    .filter(col("valor").isNotNull())
    # Garantiza el tipo numérico. Para valores monetarios, en proyectos reales
    # prefiere decimal a double, para evitar errores de redondeo
    .withColumn("valor", col("valor").cast("double"))
)

# Escritura como tabla Delta administrada
(
    df_limpo.write.format("delta")
    # overwrite: sobrescribe la tabla en cada ejecución (Delta registra una nueva versión en el log)
    .mode("overwrite")
    # saveAsTable: escribe y registra la tabla por nombre en el lakehouse (aparece en Tables)
    .saveAsTable("fato_vendas")
)

print("¡Tabla Delta 'fato_vendas' creada con éxito en lh_silver!")
Qué hace cada paso
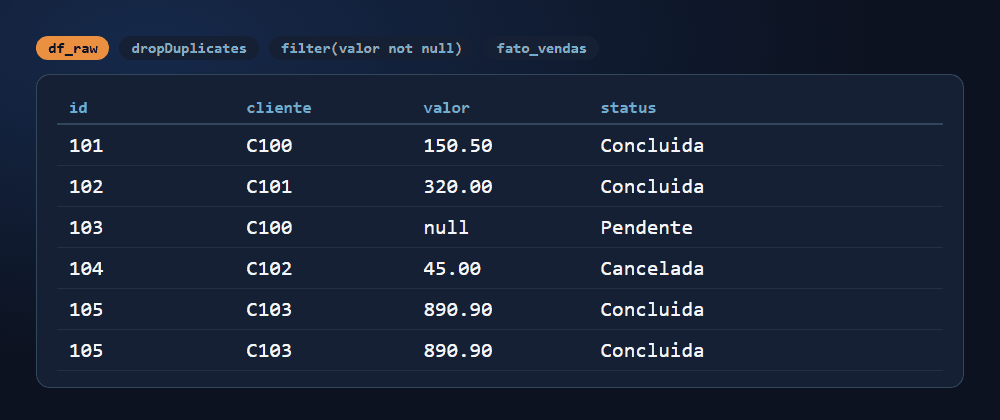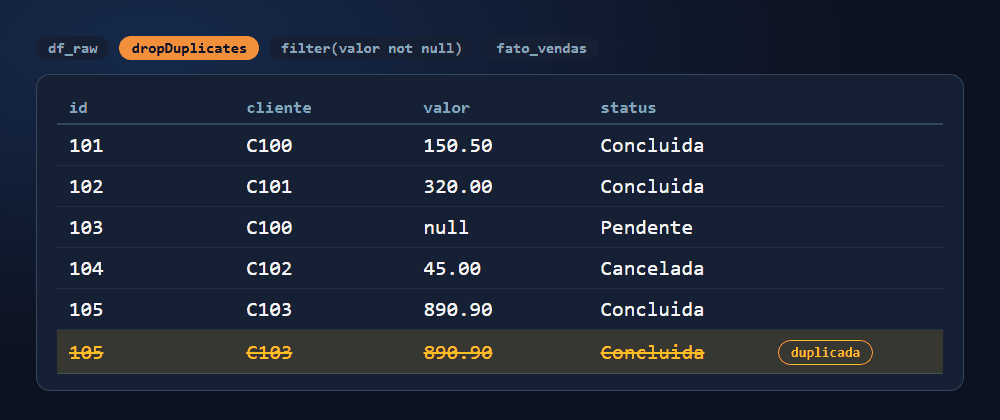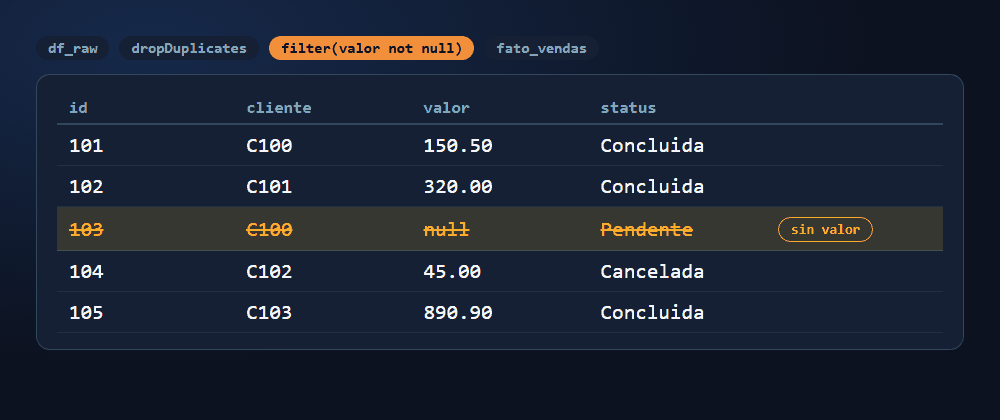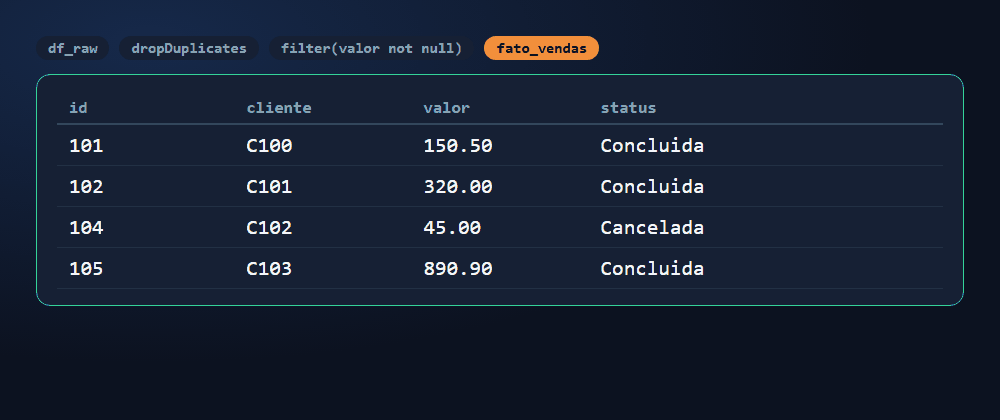
dropDuplicates(["id_transacao"]): elimina los registros repetidos, usando el ID de la transacción como clave. Es el caso de la transacción 105.filter(col("valor").isNotNull()): mantiene solo los registros con valor completo. La transacción 103, sin valor, queda afuera.cast("double"): convierte la columnavaloral tipo numéricodouble, garantizando que se trate como número.
Antes y después: de seis registros, quedan cuatro (101, 102, 104 y 105). Los comentarios del código recuerdan que descartar registros sin valor es una decisión de negocio y que, para dinero, decimal suele ser mejor que double.
Guardando la tabla Delta
format("delta"): escribe en formato Delta.mode("overwrite"): sobrescribe el contenido de la tabla en cada ejecución. Eso permite correr el notebook varias veces sin duplicar datos. Delta registra la sobrescritura como una nueva versión en el log.saveAsTable("fato_vendas"): escribe los datos y registra la tabla por nombre en el lakehouse. Con eso aparece en Tables y se puede consultar por nombre, incluso con SQL. Si usara solosave()con una ruta, los archivos se escribirían, pero la tabla no quedaría registrada por nombre en el catálogo.
La animación muestra qué ocurre por debajo cuando se escribe: la primera vez crea un archivo Parquet y una entrada en el Delta log; correrlo de nuevo con overwrite crea una nueva versión.
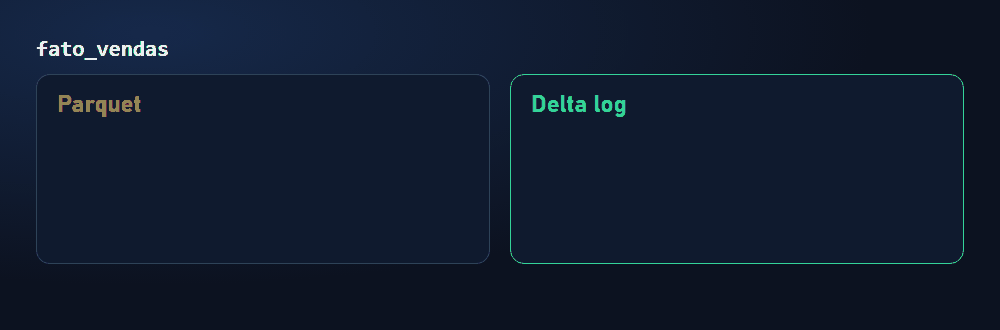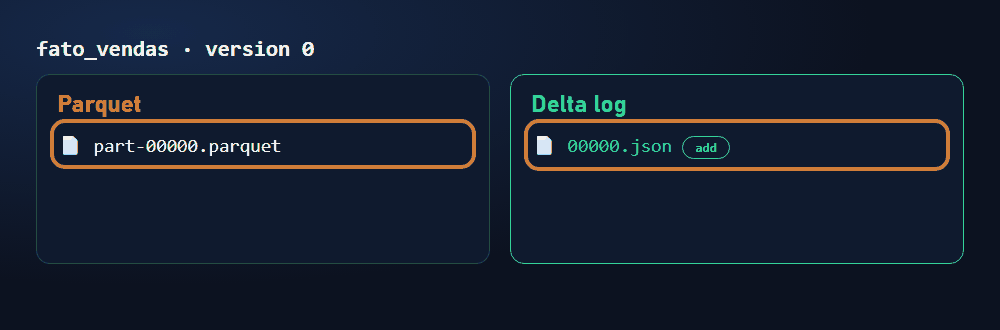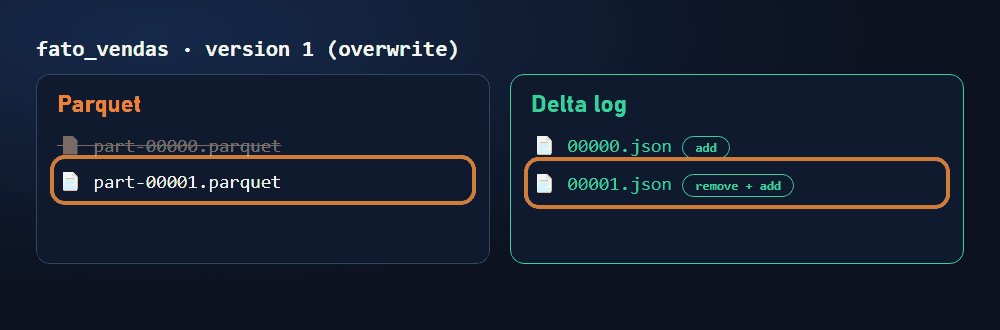
Como lh_silver es el lakehouse predeterminado del notebook, la tabla se crea en Tables, como tabla administrada: Fabric se encarga tanto de los archivos como de los metadatos.
Resultado
En silver, en Tables, aparece la tabla fato_vendas. El ícono con un triángulo indica que está en formato Delta.

Esto cierra la explicación del shortcut de la parte 3: podría haber convertido el CSV a Delta al crear el shortcut, pero preferí mantenerlo en CSV, tratar los datos en el notebook y solo entonces guardarlos en Delta.
Por debajo del capó: qué es una tabla Delta
Todo lo que está en Tables es una tabla Delta. Por debajo, está formada por dos partes:
- Archivos Parquet: guardan los datos en formato columnar y comprimido, lo que permite almacenar y consultar grandes volúmenes de forma optimizada.
- Delta log (la carpeta
_delta_log): el registro de cada transacción de escritura hecha en la tabla.

Parquet y Delta no son lo mismo. Los datos se guardan en Parquet, pero lo que los convierte en una tabla Delta es el log de transacciones que acompaña a los archivos. Por eso hablamos de "tablas Delta" o "datos en formato Delta", y no solo de Parquet.
Transacciones ACID
Es el Delta log el que permite las transacciones ACID en las tablas del lakehouse:
- Atomicidad: la operación ocurre completa o no ocurre. Si algo falla a mitad de camino, nada se escribe a medias.
- Consistencia: los datos pasan de un estado válido a otro estado válido, respetando las reglas definidas.
- Aislamiento: las transacciones simultáneas no interfieren entre sí.
- Durabilidad: una vez confirmada, la escritura es permanente, incluso si hay un corte de energía o de internet.

Preguntas frecuentes
¿Cuál es la diferencia entre save y saveAsTable?
saveAsTable escribe los datos y registra la tabla por nombre en el lakehouse, así que aparece en Tables y se puede consultar por nombre, incluso con SQL. save con una ruta escribe los archivos, pero no registra la tabla por nombre en el catálogo.
¿Qué pasa si vuelvo a ejecutar el notebook?
Con mode("overwrite"), la tabla se reemplaza por el nuevo resultado y los datos no se duplican. Delta registra la sobrescritura como una nueva versión en el log.
¿Parquet y Delta son lo mismo?
No. Parquet es el formato de archivo que guarda los datos, de forma columnar y comprimida. Delta es Parquet más el Delta log, el registro de transacciones que respalda ACID.
¿Se puede volver a la versión anterior de la tabla?
En general sí. Como cada escritura se convierte en una versión en el Delta log, se pueden consultar versiones anteriores (time travel) mientras los archivos antiguos no hayan sido eliminados por una limpieza (VACUUM). Ese tema merece un capítulo propio.
Para profundizar (documentación de Microsoft)
Resumen
- Tratamos los datos con PySpark: eliminamos el duplicado, descartamos el registro sin valor y garantizamos el tipo numérico.
- Guardamos el resultado como la tabla Delta
fato_vendas, en Tables, consaveAsTable. - Una tabla Delta está hecha de archivos Parquet más el Delta log, y es el log el que garantiza las transacciones ACID.
En la parte 5, vamos a consultar fato_vendas con el SQL analytics endpoint.